Кластеризация запросов с ИИ: от Wordstat к плану страниц
Обновлено в августе 2026.
Раздел практики: SEO и ИИ · контент.
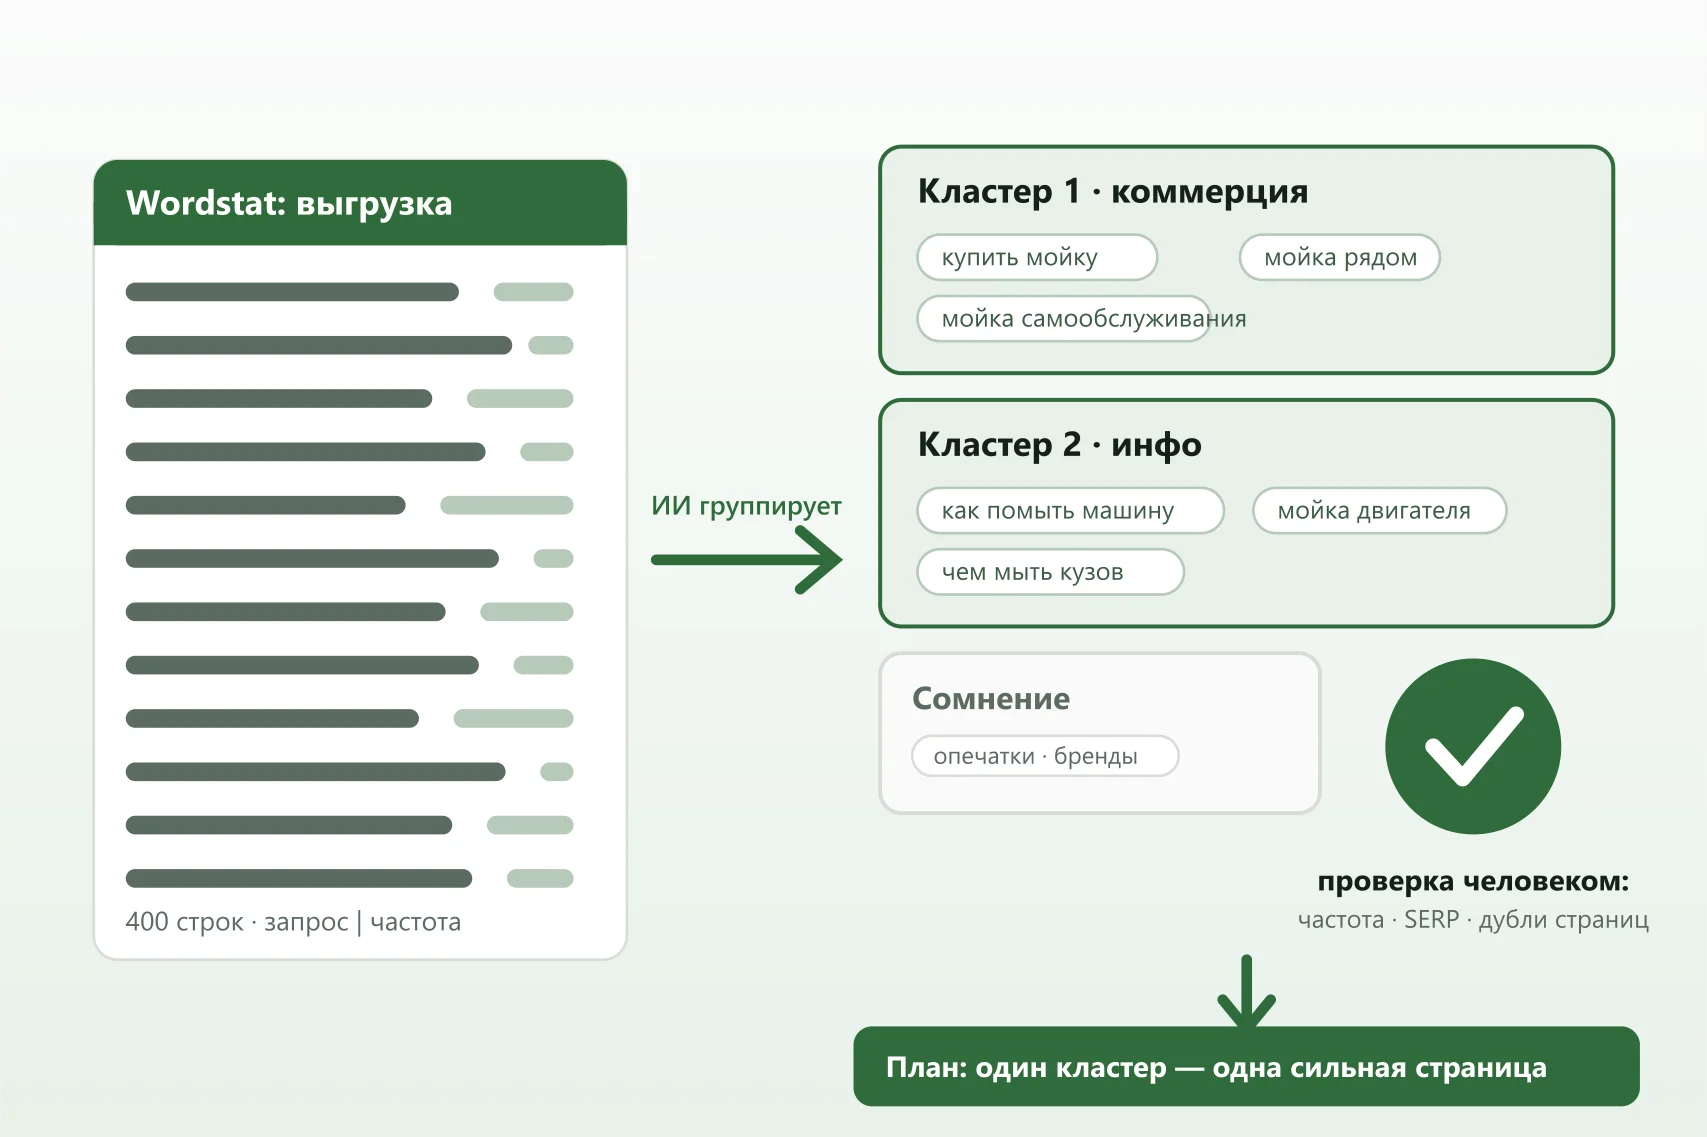
- 1СырьёWordstat + кабинеты
- 2МодельКластеры и интенты
- 3ПроверкаЧастота и SERP
- 4ПланОдин кластер — один URL
Сделайте сегодня: Возьмите 50–100 запросов по одной теме, прогоните через модель и вручную сверьте частоту двух главных кластеров в Wordstat.
В феврале 2026 выгрузил из Wordstat 320 запросов по теме «SEO-аудит» и скормил модели с просьбой «разложи на кластеры». Через час получил 14 групп — радость была недолгой: при ручной проверке три оказались синонимами, два кластера имели выдуманные частоты, а реальный спрос подтвердился у 9 из 14. С тех пор на bigfozzy.com кластеризация идёт в три прохода: модель группирует, я сверяю частоту в Wordstat и топ в выдаче, и только потом — план страниц. Ниже — как это работает на практике, с цифрами и ошибками.
Карта темы: SEO и ИИ на практике. База по структуре: структура и семантика.
Что собирать до модели
Кластеризовать стоит не «всё подряд», а одну тему или один раздел сайта. Сырьё — таблица «запрос | частота | источник». На bigfozzy.com я начинаю с Wordstat: базовая частота по теме + «что ищут со словом» (хвост), плюс связанные запросы — для интента и синонимов. К этому добавляю экспорт запросов из GSC и Яндекс.Вебмастера: что уже приводит на сайт. И отдельно — список текущих страниц раздела с URL и главным запросом каждой. Частоты держите в таблице, а не в голове: модель будет группировать, но не должна «вспоминать» цифры.
Что получилось на bigfozzy.com
С января по июль 2026 я прогнал через кластеризацию пять тем — от «SEO-аудит» до «монетизация AdSense». Сводка по результатам:
| Тема | Запросов в выгрузке | Кластеров от модели | Подтверждено после проверки | Новых страниц |
|---|---|---|---|---|
| SEO-аудит | 320 | 14 | 9 | 3 |
| Монетизация AdSense | 210 | 11 | 7 | 2 |
| Техническое SEO | 180 | 9 | 6 | 2 |
| Контент для SEO | 260 | 13 | 8 | 3 |
| Продвижение и ссылки | 150 | 8 | 5 | 1 |
Итого: 1120 запросов, 55 кластеров от модели, 35 подтверждено (64%), 11 новых страниц. На проверку каждого кластера уходило 10–15 минут: Wordstat + топ-10 в выдаче + сверка с текущими URL. Без модели я бы собирал те же кластеры вручную за 3–4 дня; с моделью и проверкой — за 2 дня.
Не отдавайте всю выгрузку разом: на 1000+ строк границы кластеров смазываются. Рабочий размер пакета — 100–300 строк одной темы.
Роль: аналитик семантики. Ниже — таблица «запрос | частота» по теме
«мойка автомобилей» (100 строк, регион: Москва).

Задача:
1. Разложи запросы на кластеры по смыслу (не по общим словам).
2. Для каждого кластера: название, главный запрос, интент
   (инфо / коммерция / навигация), сумма частот по таблице.
3. Отдельно выпиши запросы-синонимы, которые должны попасть
   на одну страницу, и шум (опечатки, чужие бренды, нулевые).

Формат: таблица «кластер | главный запрос | интент | частота | примеры».
Ограничения: не выдумывай частоты — считай только из таблицы;
если запрос некуда отнести — в «сомнение», не в кластер.
Синонимы и «похожие» формулировки модель видит неплохо; спорные случаи оставляйте в «сомнении» и разбирайте вручную.
Что проверяет человек
Вывод модели — черновик. Перед планом страниц каждая строка проходит проверку.
| Вывод модели | Как проверить вручную |
|---|---|
| «Кластер с спросом N» | Частота главного запроса в Wordstat: N — по таблице, а не по «похожим»; регион тот же |
| «Интент: коммерция» | Открыть топ-10 по главному запросу: кто стоит — магазины, статьи, агрегаторы |
| «Два кластера разные» | Сравнить топ-10 обоих главных запросов: одни и те же страницы — значит, это один кластер |
| «Нужна новая страница» | Свериться со списком текущих URL: не ранжируется ли уже кто-то по этому кластеру (каннибализация) |
| «Шум / нулевые» | Прогнать 5–10 штук через Wordstat: действительно ли частота около нуля |
Правило то же, что в техаудите с ИИ: неподтверждённое возвращается модели, а не в план.
Как я превращаю кластеры в план страниц
Один кластер — одна сильная страница. Синонимы и хвост закрываются текстом и подзаголовками, а не новыми URL: пачка страниц под синонимы — это дубли и спор за один и тот же запрос.
После проверки я открываю таблицу с подтверждёнными кластерами и текущими URL сайта. Сначала сопоставляю: какие кластеры уже закрыты существующими страницами — их помечаю «обновить», а не «создать». Например, по кластеру «SEO-аудит чеклист» уже была статья — я дописал в неё разделы по недостающим подтемам, а не сделал новую.
Новые страницы идут только под кластер с подтверждённой частотой и понятным интентом. Приоритет — частота × близость к теме сайта, а не «модель сказала интересно». На bigfozzy.com из 35 подтверждённых кластеров 24 уже имели подходящие URL, а 11 потребовали новых страниц — и на каждую я выделил 3–5 входящих ссылок со смежных разделов.
Хвостовые и нулевые запросы уходят в текст и FAQ основной страницы кластера, а не в отдельные URL. Оформление плана: контент-план и обновление URL. Перелинковка: внутренняя перелинковка.
Где я ловил ошибки модели
За полгода кластеризации на bigfozzy.com модель четыре раза уверенно выдумывала частоты, которых не было в таблице. Один раз смешала «купить мойку» и «как помыть машину» в один кластер — два разных интента, две разные страницы. А «мойка москва» и «мойка в москве» модель корректно сложила в один кластер, но «мойка казань» отправила туда же — регион не тот.
Самая частая ошибка — «100 страниц под ключи» за вечер. Тонкие страницы без пользы — прямой путь к фильтрам: фильтры и риски. По данным Semrush Research (2025), страницы с каннибализацией запросов теряют до 30% трафика за квартал — и кластеризация без проверки как раз создаёт этот эффект.
Текст по готовому кластеру пишется по брифу: бриф и промпты для SEO-текста. Проверка результата — в кабинетах: Вебмастер и GSC.
Что будет с кластеризацией к 2027
Модели научатся учитывать регион и морфологию без подсказок — но частоту всё равно придётся сверять в Wordstat. Появятся специализированные инструменты «Wordstat → кластеры → план страниц» с проверкой спроса на лету; сейчас их нет. Ручная проверка интента по топу останется обязательной: модель не видит выдачу в реальном времени. А кластеризация на 1000+ запросов станет рабочей, а не «пакетами по 300» — но только с привязкой к кабинету, а не к чату.
Ежемесячный ритм кластеризации
Я не кластеризую «всё сразу» — это одна тема в месяц, по мере появления нового контента в плане.
| Неделя | Что делаю | Время |
|---|---|---|
| 1-я | Выгрузка Wordstat по теме месяца + экспорт GSC по этому разделу. Таблица «запрос | частота | источник». | 1–2 часа |
| 2-я | Прогоняю 100–300 строк через модель. Получаю кластеры, интенты и «сомнение». | 1 час + ожидание |
| 3-я | Проверяю каждый кластер: частота в Wordstat, топ-10 в выдаче, сверка с текущими URL. Отсеиваю неподтверждённые. | 2–3 часа |
| 4-я | План страниц: обновить существующие или создать новые. 3–5 входящих ссылок на каждую. Задача в трекер. | 1 час |
За год такой ритм дал 11 новых страниц и 24 обновления — все с подтверждённым спросом, ни одной «модель так сказала». См. также бриф и промпты для текста и проверку в кабинетах.
По теме: сборник промптов · структура и семантика · AI-контент · ИИ для техаудита · курс.
Частые вопросы
Можно ли отдать модели всю выгрузку Wordstat сразу?
Нет. Пакетами по 100–300 строк с колонками «запрос» и «частота». На большой свалке модель смазывает границы кластеров и «усредняет» частоты.
Заменяет ли ИИ проверку спроса?
Нет. Модель предлагает группы и интенты, а частоту главного запроса и состав топа вы сверяете в Wordstat и кабинетах вручную.
Сколько страниц делать под один кластер?
Одну сильную. Синонимы и хвостовые формулировки закрываются в тексте и подзаголовках, а не отдельными URL.
Что делать с «нулевыми» запросами из хвоста?
Не создавать под них страницы. Часть идёт в текст и FAQ основной страницы, остальное — в корзину: спрос не подтверждён.